
В ноябре 2024 года Coca-Cola выпустила рождественский ролик «The Holiday Magic Is Coming» – оммаж на культовую рекламу 1995 года с колонной грузовиков в гирляндах. Только на этот раз ни одного человека в кадре не снимали: ролик целиком сгенерировали нейросети. Реакция была почти единодушной – зрители называли его бездушным, жутким, называли происходящее «смертью искусства». Кто-то писал, что Coca-Cola просто сэкономила на художниках.
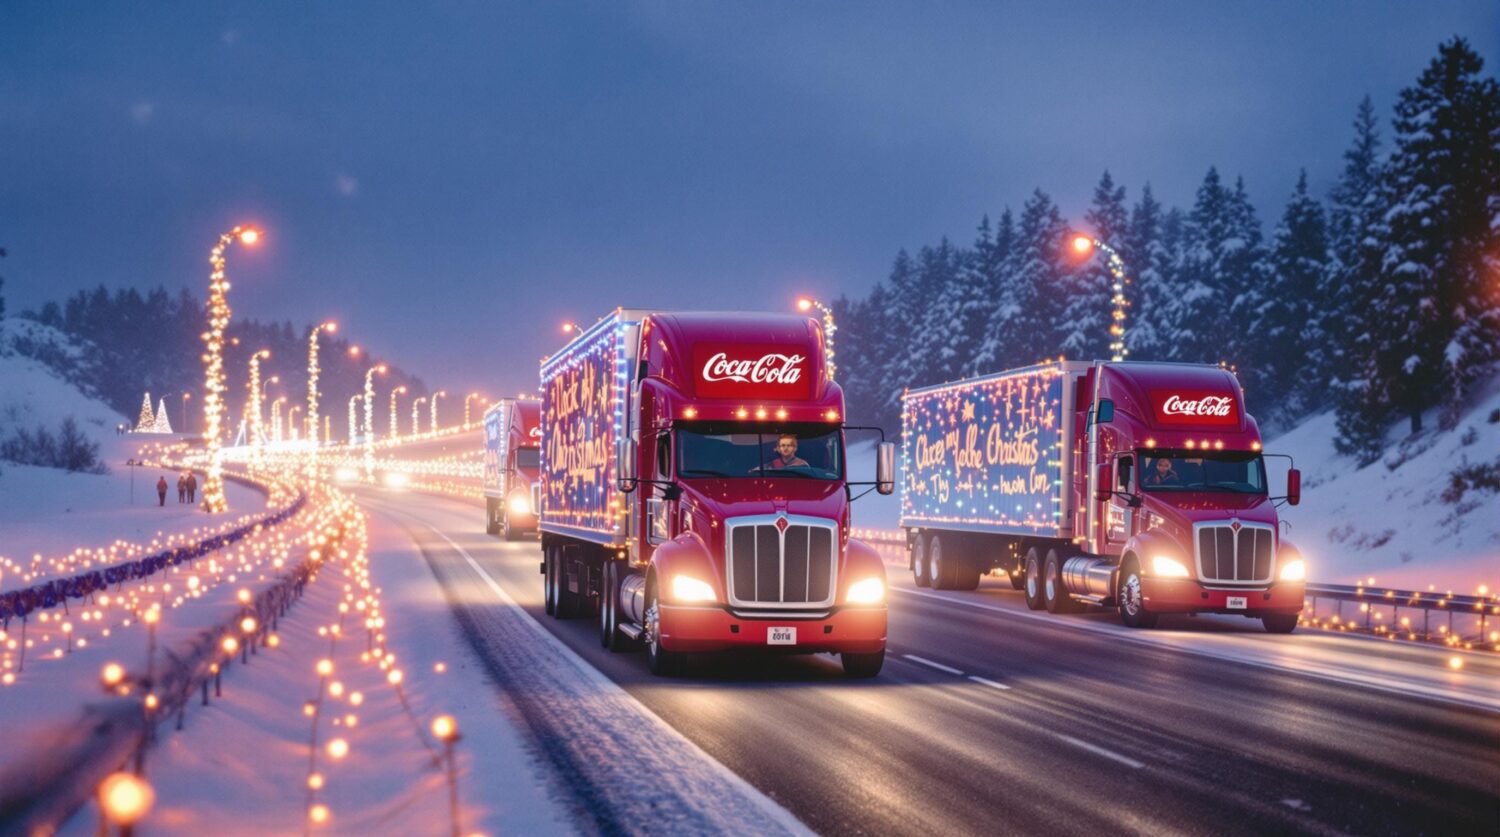
Дальше начинается менее очевидная часть истории. Над роликом работали три независимые AI-студии – Secret Level, Silverside AI и Wild Card, – которые около двух месяцев собирали кадр за кадром, вручную выправляя то, что нейросеть выдавала неправильно: колёса грузовика, которые не крутились при движении, застывшее содержимое бутылок, искажённые пропорции рук. Это не «нажал кнопку – получил ролик» – это итеративная, довольно кропотливая работа людей, которую зритель просто не увидел за словом «AI».
Вот с этого противоречия и стоит начинать разговор про AI в рекламе – потому что именно здесь сходятся сразу два больших конфликта, из-за которых тема вызывает у людей эмоции, а не просто мнение.
Обществу не мешает AI. Ему мешает подмена человека
Если разложить отношение к AI-рекламе по задачам, а не оценивать его одним числом, картина становится куда яснее. Опрос Gallup и Bentley University среди американцев в 2026 году показал: 75% считают нормальным, если бизнес использует AI для мозгового штурма и черновиков рекламы – при условии честного раскрытия. Для финального текста, изображения или видео согласных уже меньше – 53%. А вот генерировать лица и голоса реальных людей одобряют всего 38% – 62% против, даже если использование AI прямо указано.
Разрыв в 37 процентных пунктов между «AI помогает придумать идею» и «AI выдаёт себя за человека» – это не случайность. Именно в этой точке недовольство рекламой пересекается с гораздо более старым и куда более организованным конфликтом – тем, что уже несколько лет идёт в Голливуде и в книгоиздании.
Голливуд уже прошёл через это – с забастовками
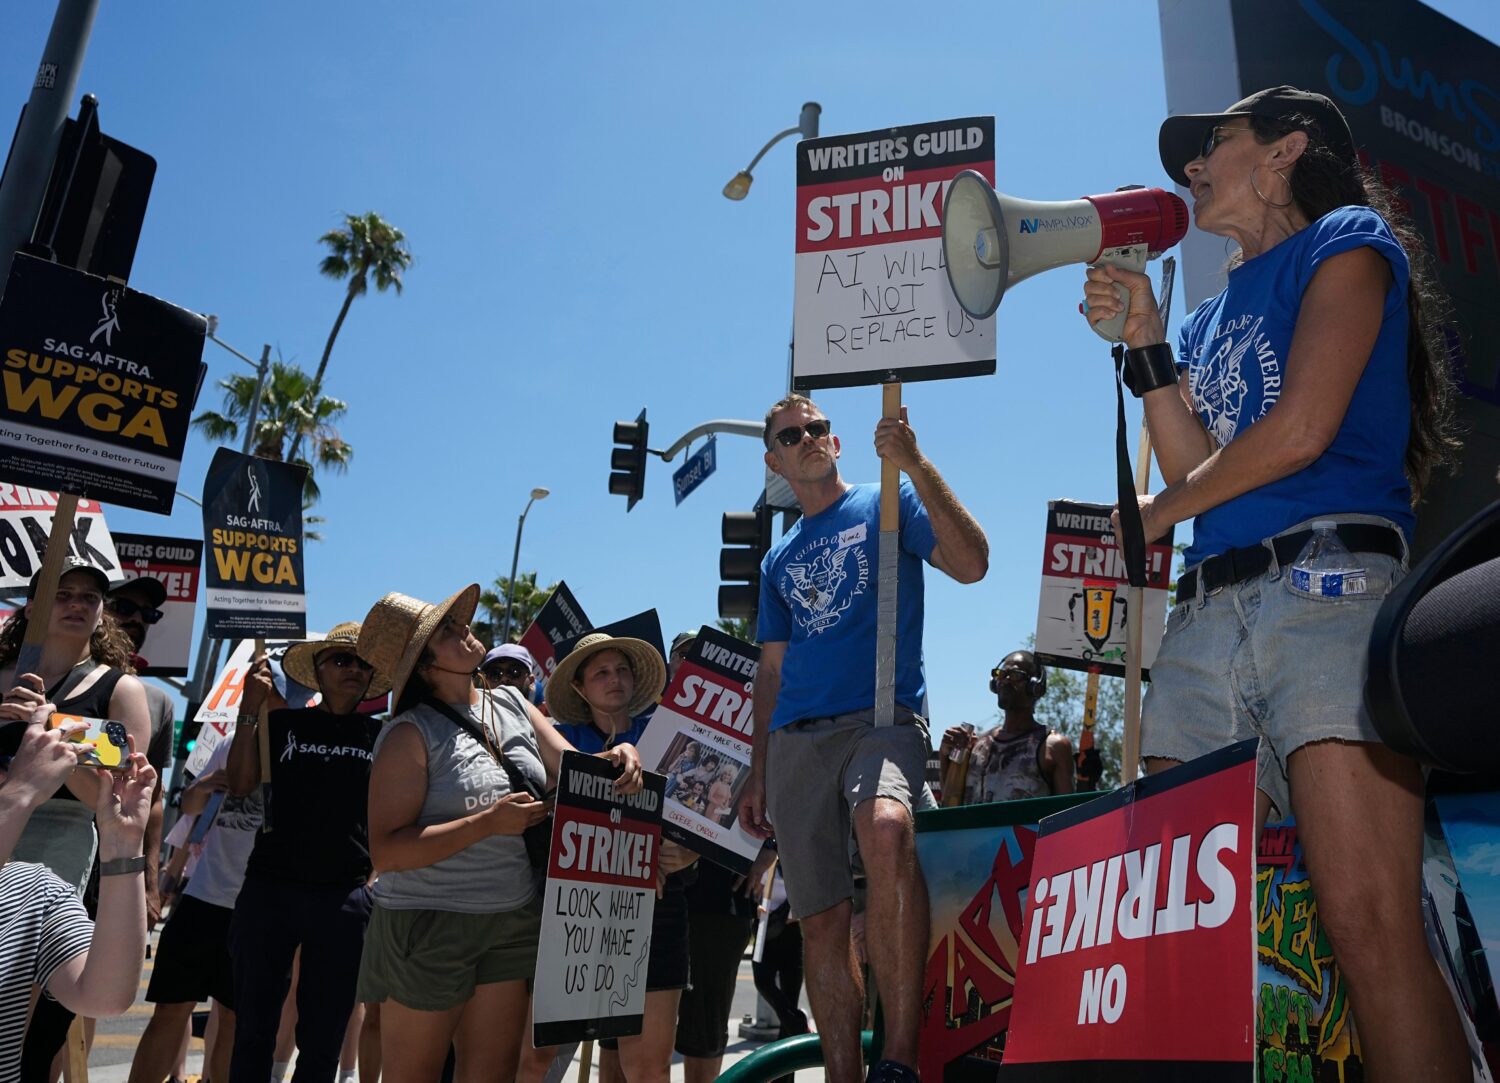
Осенью 2023 года SAG-AFTRA, профсоюз американских актёров, и Гильдия сценаристов на несколько месяцев остановили съёмки фильмов и сериалов – в том числе из-за требований прописать правила использования AI. В декабре 2023 года актёры проголосовали за новое соглашение – 78,33% поддержали ратификацию. Соглашение впервые ввело понятие «цифрового двойника» и разделило его на два вида: созданный в рамках конкретного проекта и созданный независимо, из уже существующих материалов. В обоих случаях требуется осознанное согласие актёра и отдельная компенсация – при этом продюсер по-прежнему может отказать в найме тому, кто откажется от сканирования, только теперь это должно быть заявлено заранее, а не всплывать на площадке.
За соглашением последовало законодательство: в 2024 году Калифорния приняла законы AB 1836 и AB 2602, закрепляющие права на голос и внешность в контексте цифровых двойников, а в Конгресс внесли федеральный NO FAKES Act – при поддержке, что показательно, не только киностудий, но и самой OpenAI. То есть даже разработчики генеративных моделей публично согласились, что право человека на собственное лицо и голос нуждается в отдельной защите от их же технологии.
Авторы книг судятся прямо сейчас
Параллельная история – в книгоиздании. Ещё в сентябре 2023 года Гильдия авторов США вместе с писателями, среди которых Джон Гришэм и Джордж Мартин, подала коллективный иск к OpenAI: утверждали, что их книги использовали для обучения моделей без разрешения и без единой выплаты. Это не разовая история и не закрытое дело – 4 сентября 2026 года истцы подали ходатайство о вынесении решения в порядке упрощённого судопроизводства, дело рассматривается в федеральном суде Южного округа Нью-Йорка. Ответчики подали встречное ходатайство. Иными словами, спор о том, чей труд лежит в основе AI-моделей и кому за него причитается, далеко не закрыт – он в эту секунду находится в зале суда.
Если сложить обе истории вместе, видно, что тревога, которую показывают опросы, не абстрактная. У неё есть конкретные лица, конкретные иски и конкретные условия труда, за которые люди годами боролись через забастовки и суды.
А что с теми, кто и правда работает с AI
Здесь начинается вторая, менее удобная часть разговора. Те самые три студии, что два месяца вручную дорабатывали ролик для Coca-Cola, – это не безликий алгоритм, а команды людей с профессией, которой пять лет назад ещё не существовало. Управлять генеративной моделью так, чтобы результат не выглядел как случайный набор картинок, – это в равной степени вкус, техническая экспертиза и умение по десять раз переделывать один и тот же кадр, пока не исчезнет лишний палец на руке.
Спор о том, считается ли это «настоящим» творчеством, устроен ровно так же, как и предыдущие подобные споры в истории. Фотографию когда-то не признавали искусством именно потому, что она «сама всё снимает» – механически, без кисти и холста. Диджеев и сэмплирование в музыке десятилетиями обвиняли в том, что это не сочинение, а присвоение чужого труда. Каждый раз находился лагерь, который говорил «это ремесло», и лагерь, который говорил «это кража чужого мастерства, упакованная в кнопку». AI-креаторы сегодня оказались ровно в той же вилке – с той разницей, что скорость и масштаб, с которым нейросети заменяют реальных исполнителей, у фотографии и сэмплирования были другими.
Справедливости здесь обе стороны в чём-то правы, и вряд ли кто-то один расставит все точки: для актёра, чей голос использовали без его ведома, вопрос не в мастерстве промпт-инженера, а в согласии и контроле над собственным образом. Для человека, который два месяца вручную выправлял кадры за Coca-Cola, вопрос не в этике, а в том, что его труд обесценили одним словом «AI» в титрах – или вовсе не упомянули.
Что не показывают опросы, но показывают деньги
Если вынести спор об этике за скобки и посмотреть просто на то, как по-разному люди готовы мириться с AI-рекламой в разных странах, разброс тоже показательный. Ipsos AI Monitor 2026 – 32 страны, больше 23 тысяч респондентов – спрашивал, насколько комфортно людям, если создание рекламного контента бренда будет выполнять преимущественно AI.
| Страна | Комфортно с AI в рекламном контенте бренда |
| Китай | 86% |
| Индия | 82% |
| ЮАР | 80% |
| Индонезия | 79% |
| Перу | 78% |
| Мексика | 72% |
| Среднее по 32 странам | 61% |
| Испания | 55% |
| Италия | 50% |
| США | 49% |
| Великобритания | 48% |
| Франция | 47% |
| Канада | 43% |
| Германия | 42% |
Разброс почти вдвое – и коррелирует не с самой рекламой, а с общим уровнем доверия к AI в стране: США, Великобритания, Канада, Германия и Франция стабильно внизу почти по всем показателям отчёта, а не только по рекламе. Это скорее показывает, что реклама – лишь одна из точек, где проявляется более общая тревога, а не отдельная её причина.
Единственное, с чем согласны почти все, – раскрытие обязательно
При всём разбросе мнений есть пункт, где мир на редкость единодушен: 80% в среднем по 32 странам считают, что продукты и сервисы, использующие AI, обязаны об этом сообщать. Это самый высокий уровень согласия по любому вопросу об AI во всём отчёте.
При этом отдельное исследование Нюрнбергского института (NIM) по США, Великобритании и Германии показывает обратную сторону: явная маркировка «сделано с помощью AI» снижает доверие и вовлечённость аудитории – особенно в Евросоюзе, где такая маркировка стала юридическим требованием. Получается негласное противоречие: люди хотят знать – но знание снижает доверие к конкретному материалу. Из истории с Coca-Cola видно то же самое: маленькая подпись «Real Magic AI» в конце ролика не спасла его от обвинений в бездушности – скорее наоборот, стала первой зацепкой для критики.
А что в России и СНГ
Ни Gallup, ни Ipsos, ни NIM не включают Россию в выборку – как и большинство крупных международных потребительских панелей последних лет, обычно просто потому, что у этих компаний здесь нет работающей панели, а не из-за отсутствия интереса к теме. Локальных данных, сопоставимых по методологии, пока нет – и переносить сюда напрямую ни американскую настороженность, ни азиатский оптимизм нельзя: рынок отличается и по цифровой культуре, и по тому, как вообще выглядит здесь AI-контент в рекламе.
Что с этим делать бренду
Из всего этого вырисовывается не лозунг «AI – это плохо» и не лозунг «весь мир уже привык», а более узкое практическое правило. Степень приемлемости зависит от задачи, а не от инструмента: черновик, идея, бриф – почти везде нормально в любой стране. Финальный визуал или текст – уже вопрос доверия к конкретному бренду. Синтетическое лицо или голос реального человека – зона повышенного риска почти везде, и именно здесь проходит грань между «AI помог» и «AI подменил».
И второе: раскрытие использования AI – это не формальность для галочки и не способ прикрыться от критики. Это то, чего аудитория ждёт независимо от страны, даже зная, что раскрытие может снизить доверие к конкретному материалу. Вопрос не в том, говорить или нет, а в том, как – так, чтобы это не выглядело как оправдание, а выглядело как часть истории. Тем более что за словом «AI» почти всегда стоят студии, монтажёры и промпт-инженеры, чей труд остаётся невидимым ровно тогда, когда бренду проще сказать «это сделала нейросеть», чем объяснить, кто и как на самом деле это сделал.
У многих рекламодателей есть негласное правило: не размещаться рядом с «тяжёлыми» темами — политикой, происшествиями, любыми новостями, которые могут показаться спорными. Логика понятна: страшно, что бренд «свяжут» с неприятным контекстом. Но чем больше данных накапливается на этот счёт, тем очевиднее, что это правило — миф, который стоит рекламодателям реального охвата.
Что показывают данные
В одном из недавних масштабных исследований медиасреды сравнивали, как аудитория воспринимает рекламу рядом с «неудобными» новостями (например, о политике или происшествиях) и рядом с нейтральным, «безопасным» контентом. Результат: показатели восприятия бренда — покупательское намерение, лояльность и другие репутационные метрики — оказались практически идентичны в обоих случаях (около 67% благоприятного восприятия что рядом с «небезопасным», что рядом с «безопасным» контентом), причём разница не зависела от возраста, дохода, образования или региона аудитории.
Иначе говоря, реклама рядом с серьёзной темой не портит впечатление о бренде сама по себе. Портит его другое: доверие к самой площадке, где реклама размещена. Отдельные измерения показывают, что размещение в изданиях с высоким уровнем доверия аудитории само по себе повышает репутационные метрики бренда — по некоторым оценкам, на четверть по сравнению с размещением в среднестатистической среде. То есть эффект работает не через избегание «опасных» тем, а через выбор площадки с высоким кредитом доверия у своей аудитории.
Откуда взялись блок-листы и почему они устарели
Осторожность рекламодателей возникла не на пустом месте. Рост числа фейковых новостей и информационных вбросов последних лет закономерно напугал часть рынка: никто не хочет, чтобы логотип бренда оказался визуально рядом с очевидно токсичным материалом. Ответом стали автоматические блок-листы — список «опасных» слов, при появлении которых система исключает публикацию из показа рекламы независимо от контекста.
Проблема в грубости самого механизма. Блок-лист не различает, встретилось ли слово «кризис» в панической жёлтой заметке или в добротном аналитическом разборе экономической ситуации в деловом издании. Формально оба текста «токсичны» по одному и тому же критерию, хотя по сути и по риску для бренда они противоположны. На практике это означает, что рекламодатели массово теряют доступ к качественной, вовлечённой аудитории — не из-за реального репутационного риска, а из-за формального совпадения по ключевому слову.
Что приходит на смену: контекстный AI-таргетинг
Более новые инструменты бренд-безопасности анализируют не отдельные слова, а тон, тематику и реальный риск публикации целиком — то есть пытаются понять, о чём материал и как он подан, а не просто искать триггерные слова в тексте. Это позволяет отличить материал, который действительно может навредить репутации бренда, от добротного журналистского текста на серьёзную тему, и открывает рекламодателям доступ к аудиториям, которые раньше блокировались «на всякий случай».
Особенно это важно на фоне общего роста недоверия к информации в интернете: чем больше в ленте случайного и низкокачественного контента, тем сильнее аудитория тянется к проверенным источникам — и тем больше смысла у рекламодателя размещаться именно там, а не избегать таких площадок из осторожности.
Экономический аргумент: безопасный контент стоит дороже, а не эффективнее
У массового избегания «серьёзных» тем есть побочный эффект, о котором реже говорят: рекламодатели, которые все одновременно бегут в узкий пул формально «безопасного» контента, начинают конкурировать за один и тот же, ограниченный по объёму инвентарь. Это закономерно повышает его стоимость — притом что, как показывают данные, реклама там не работает лучше, чем в спокойно поданном материале на серьёзную тему. По сути часть рекламных бюджетов сегодня переплачивает за иллюзию безопасности, а не за реальный прирост эффективности.
Что стоит пересмотреть уже сейчас
- Аудировать текущий список стоп-слов и блокировок — часть из них может отсекать не риск, а качественный контент без реальных оснований.
- Тестировать размещение в проверенных, но «неудобных» тематических блоках вместо автоматического исключения — с контролем метрик, а не вслепую.
- При выборе инструментов бренд-безопасности отдавать предпочтение решениям с контекстным анализом тона и тематики, а не спискам ключевых слов.
- Оценивать площадку размещения по её репутации и уровню доверия аудитории, а не по формальной «безопасности» темы конкретной публикации.
Осторожность рекламодателей понятна, но данные говорят об обратном тому, что подсказывает интуиция: не тема статьи определяет восприятие бренда, а доверие к источнику. Отказ от серьёзного, но качественного контента — это не защита репутации, а упущенный охват и лишние траты там, где аудитория сегодня внимательнее и вовлечённее всего.
Ещё пару лет назад проверка маркировки интернет-рекламы во многом держалась на жалобах пользователей и выборочных проверках. Сейчас основную работу всё чаще делают алгоритмы: система сопоставляет данные из Единого реестра интернет-рекламы (ЕРИР) с тем, что реально опубликовано в сети, — и делает это в режиме, близком к реальному времени.
Как это работает технически: путь от креатива до дела о нарушении
Логика простая, но требует точности на каждом шаге, потому что теперь любой сбой в цепочке виден алгоритму. Полный путь выглядит примерно так:
- Договор и распределение ролей. Стороны фиксируют, кто отвечает за регистрацию креатива в ОРД и подачу отчётности — рекламодатель, агентство или сам паблишер.
- Регистрация в ОРД. Креатив со всеми элементами макета — текстом, изображением, ссылками, промокодами — регистрируется у оператора рекламных данных, который присваивает ему уникальный токен erid.
- Публикация с меткой. Материал выходит с надписью «Реклама», данными о рекламодателе и токеном — все три элемента обязательны одновременно.
- Передача данных в ЕРИР. ОРД передаёт сведения о размещении в Единый реестр интернет-рекламы — фактически создаётся официальная «карточка» этого рекламного размещения.
- Автоматическое сканирование. Парсер массово обходит сайты, соцсети и мессенджеры и сопоставляет то, что реально опубликовано, с тем, что заявлено в ЕРИР: есть ли пометка, присутствует ли токен, совпадают ли данные о рекламодателе.
- Формирование материала о нарушении. Если хотя бы один элемент не совпадает или отсутствует, система формирует материал для возбуждения административного дела — без участия человека на этом этапе.
- Проверка сотрудниками регулятора. Уже сформированные автоматически материалы дополнительно перепроверяются вручную перед тем, как по ним возбуждают дело — то есть финальное решение всё ещё принимает человек, но отбор кандидатов на проверку теперь полностью машинный.
Раньше расхождения такого рода находили в основном вручную — по жалобам конкурентов или пользователей, и до этапа проверки доходила лишь небольшая часть всех размещений. Представитель РКН публично упоминал, что уже на ранней стадии внедрения такой системы было возбуждено несколько десятков административных дел именно по результатам автоматического анализа — то есть это не гипотетический риск на будущее, а работающий механизм.
Что чаще всего ловит автоматическая проверка
По данным разборов практики применения закона, среди самых частых и при этом самых дорогих ошибок — не злой умысел, а технические недочёты, которые легко пропустить при большом объёме размещений.
- Реклама без токена. Пометка «Реклама» и данные о рекламодателе на месте, а сам код erid отсутствует — для системы такой материал неотличим от полностью немаркированной рекламы, потому что именно токен связывает публикацию с записью в реестре.
- Замена слова «Реклама» на синонимы или сокращения — «промо», «партнёрский материал», «АД» — закон признаёт только точную формулировку, и любое отклонение читается как отсутствие пометки.
- Несовпадение данных о рекламодателе — например, в креативе указано юрлицо, отличное от того, что зарегистрировано в ЕРИР при подаче через ОРД, из-за смены посредника в цепочке или банальной опечатки.
- Отсутствие повторной регистрации при изменении креатива — если в уже размещённый материал внесли правки (поменяли цену, текст, изображение), формально это уже другой креатив, которому нужен собственный токен.
Почему это меняет расклад для рекламодателей
Раньше несистемная ошибка — забытый токен в одном из десятков объявлений, опечатка в названии рекламодателя — могла остаться незамеченной месяцами. При автоматической проверке в реальном времени такие ошибки находятся значительно быстрее, а их количество на масштабе (у крупного рекламодателя или агентства, ведущего десятки кампаний одновременно у нескольких подрядчиков) становится куда заметнее: если ошибка системная — например, в шаблоне, по которому агентство собирает креативы — алгоритм отловит её во всех размещениях сразу, а не в одном случайном.
Это не история про то, что требования стали строже — сам закон о маркировке не изменился с 2022–2023 годов. Изменилось то, насколько неотвратимо теперь находят нарушения, которые раньше могли остаться незамеченными просто из-за объёма ручной работы, необходимого для их поиска.
На что стоит обратить внимание в первую очередь
- Токен erid должен быть на каждом креативе без исключений — включая ситуации, когда один макет используется сразу на нескольких площадках, и каждый раз, когда в материал вносятся изменения.
- Данные о рекламодателе в публикации должны дословно совпадать с тем, что зарегистрировано в ЕРИР — расхождения в названии компании или ИНН читаются алгоритмом как несоответствие, даже если по сути это одна и та же кампания.
- Формулировка «Реклама» — единственная, которую признаёт закон; синонимы и сокращения не защищают от штрафа.
- При работе через нескольких подрядчиков стоит явно закрепить в договоре, кто отвечает за регистрацию в ОРД и подачу отчётов, а также обязать партнёра хранить подтверждения регистрации и скриншоты опубликованных материалов не менее года — при автоматической проверке разбираться постфактум, кто виноват, будет уже поздно.
Как самостоятельно сверить активные размещения с ЕРИР
У ЕРИР и у личного кабинета ОРД разные задачи: в кабинете ОРД вы регистрируете креативы и получаете токены, а публичный сервис ЕРИР показывает, как эти данные в итоге отразились в государственном реестре — именно с этим представлением и сверяется автоматическая проверка регулятора. Сверка вручную делается в несколько шагов.
- Собрать реестр активных размещений. Выгрузить по всем площадкам и подрядчикам единую таблицу: площадка, креатив, дата запуска, ответственный за регистрацию, присвоенный erid.
- Проверить каждый erid в публичном сервисе ЕРИР. Токен или ссылку на публикацию можно вставить прямо в поисковую строку сервиса — система покажет, зарегистрирован ли материал, кто указан рекламодателем, ИНН и дату получения токена.
- Сверить статус токена. Если креатив только что зарегистрирован в ОРД, в ЕРИР он может первое время отображаться как «в обработке» — это нормально и не повод для тревоги. А вот если статус не меняется несколько дней или токен вообще не находится в реестре, это сигнал разбираться с ОРД, через который он регистрировался.
- Сравнить карточку ЕРИР с фактической публикацией. Название рекламодателя, ИНН и, по возможности, содержание материала в реестре должны совпадать с тем, что реально показывается пользователю — расхождение здесь и есть тот самый триггер для автоматической проверки регулятора.
- Фиксировать расхождения отдельным списком. Не найден токен, статус завис, не совпадают данные о рекламодателе — каждый такой случай стоит сразу передавать ответственному за регистрацию (себе или подрядчику) с чётким сроком на исправление, а не откладывать до следующей сверки.
Как выстроить внутренний аудит
- Регулярная периодичность. Раз в месяц в спокойный период и еженедельно в сезон высокой активности (когда объём новых креативов резко растёт) — проводить описанную выше сверку по всем активным размещениям.
- Матрица ответственности в договорах. Явно фиксировать, кто из подрядчиков отвечает за токенизацию каждого конкретного канала — при работе с несколькими агентствами и площадками одновременно путаница в зонах ответственности встречается чаще, чем кажется.
- Проверка при любом изменении креатива. Внести в чек-лист правило: любое изменение текста, цены или визуала в уже запущенном объявлении — повод проверить, не требуется ли повторная регистрация.
- Архив подтверждений. Хранить скриншоты опубликованных материалов и подтверждения регистрации в ОРД централизованно, а не полагаться на то, что это сделает подрядчик — в случае проверки эти материалы нужны быстро.
Автоматизация модерации — это, по сути, история про то, что человеческий фактор в проверках больше не защищает от невнимательности. Раньше можно было рассчитывать, что мелкая ошибка потеряется в объёме проверок. Теперь стоит исходить из того, что найдётся практически любая — и закладывать регулярный аудит маркировки в рутину, а не разбираться с ней только после жалобы или штрафа.
Классический путь клиента — увидел рекламу, кликнул, купил — на практике почти не встречается. Пользователь видит объявление в одной соцсети, ищет бренд в поиске через день, читает отзывы в мессенджере, а покупает неделю спустя с другого устройства через прямой заход на сайт. Вопрос «какая площадка привела к продаже» в такой картине давно перестал иметь один правильный ответ.
Почему last-click больше не работает как единственная метрика
Модель «вся заслуга — последнему клику» была удобной, когда путь клиента укладывался в один-два шага. Сейчас она системно недооценивает площадки, которые работают на верхних этапах воронки — контент, охватные размещения, первое знакомство с брендом — и переоценивает точку, где пользователь просто «дозрел» и кликнул в последний раз.
Дополнительно ситуацию усложняет то, что путь клиента физически размазан между разными экосистемами: у Яндекса, VK и Telegram — разные аккаунты, разные способы отслеживания и нет единого межплатформенного cookie, который раньше упрощал сквозную аналитику.
Пример: один и тот же путь клиента, разные модели — разный вывод
Возьмём условный путь: пользователь увидел рекламный пост о бренде в соцсети (точка 1), через два дня прочитал статью в блоге с упоминанием продукта (точка 2), ещё через три дня получил ретаргетинговое объявление и перешёл на сайт, но не купил (точка 3), а покупку совершил через неделю, напрямую зайдя на сайт по прямому переходу (точка 4).
- Last click отдаст 100% ценности точке 4 — прямому заходу, который на самом деле сам по себе ничего не «продавал», а лишь завершил путь, начатый постом в соцсети.
- First click, наоборот, отдаст всю ценность точке 1 — рекламному посту, полностью проигнорировав ретаргетинг, который вернул уже почти ушедшего пользователя.
- Линейная модель разделит ценность поровну между всеми четырьмя точками по 25%, что честнее, но не учитывает, что пост в соцсети и ретаргетинг сыграли явно более активную роль, чем пассивный прямой заход.
- Data-driven модель, обученная на массиве похожих путей, обычно в такой ситуации отдаёт больший вес именно точке 1 (инициировала интерес) и точке 3 (вернула пользователя к покупке), а прямому заходу — минимальную долю, потому что статистически он редко бывает самостоятельной причиной конверсии.
Разница в выводах прямо влияет на бюджетные решения: если ориентироваться только на last-click, соцсеть и ретаргетинг в этом примере покажутся неэффективными, и бюджет с них законно, но ошибочно, могут перераспределить в пользу канала, который на самом деле просто оказался последним по времени.
Какие модели атрибуции есть в 2026 году
- Last click / first click — самые простые модели, засчитывают всю ценность последнему или первому касанию. Годятся для быстрой ориентировочной оценки, но искажают картину при длинном цикле сделки.
- Линейная модель — распределяет ценность поровну между всеми точками контакта. Честнее, чем last-click, но не учитывает, что разные касания вносят разный вклад.
- Модели с временным затуханием — отдают больше веса точкам контакта, которые были ближе по времени к конверсии, но не игнорируют совсем ранние касания. Хороший компромисс, когда данных мало для полноценной алгоритмической модели, но искажения last-click уже мешают принимать решения.
- Data-driven / алгоритмическая атрибуция — вес каждого касания определяется на основе статистики по реальным конверсионным и неконверсионным путям. Точнее остальных моделей, но требует достаточного объёма данных, чтобы алгоритму было на чём обучаться — на малых объёмах конверсий такая модель может давать нестабильные, «скачущие» веса от месяца к месяцу.
Как считать эффективность на практике, если данные разбросаны по площадкам
- Свести данные в одном месте. Если кампании ведутся на нескольких площадках через разные кабинеты, для сквозной аналитики нужен единый источник данных — агрегатор, сводный отчёт или BI-система, куда стекается статистика по всем каналам, а не набор из пяти открытых вкладок с разными интерфейсами и разными определениями конверсии.
- Навести порядок в UTM-разметке. Атрибуция любой сложности бессмысленна, если на входе разные кампании размечены непоследовательно. Стоит зафиксировать единую структуру для всех каналов — например, всегда utm_source для площадки, utm_medium для типа размещения (cpc, social, retargeting) и utm_campaign для конкретной кампании — и следить, чтобы этой структуры придерживались все, кто запускает рекламу, включая подрядчиков.
- Инвестировать в first-party данные. Чем меньше можно опереться на кросс-платформенные cookie, тем важнее собственная база: email, номера телефонов, идентификаторы CRM — как связующее звено между разными точками контакта одного и того же клиента, даже если он взаимодействовал с брендом с разных устройств и в разных экосистемах.
- Проверять модель инкрементальными тестами. Периодически стоит отключать канал, который «на бумаге» показывает низкий вклад, и смотреть, просядут ли реальные продажи — это лучше любой модели показывает, играет ли канал самостоятельную роль или дублирует эффект других.
Типичные ошибки при внедрении сквозной атрибуции
- Разная UTM-логика у разных людей и подрядчиков — из-за этого одна и та же кампания в отчётах «расползается» на несколько разных строк, и посчитать её реальный вклад становится невозможно.
- Слепое доверие к «самоотчётности» каждой площадки по отдельности. Если сложить конверсии, которые показывает каждый рекламный кабинет по отдельности, сумма почти всегда окажется больше реального числа продаж — разные площадки нередко засчитывают себе одну и ту же конверсию.
- Игнорирование ассистирующих конверсий. Канал, который сам по себе редко закрывает продажу, но регулярно появляется в цепочке перед покупкой, легко ошибочно признать неэффективным, если смотреть только на его собственные прямые конверсии.
- Отсутствие связки онлайн- и офлайн-данных для бизнеса, где часть сделок закрывается не на сайте (звонок, визит в шоурум, оффлайн-магазин) — без этой связки атрибуция по определению видит только часть пути клиента.
Идеальной модели атрибуции, которая одинаково хорошо работает для любого бизнеса, не существует — и в 2026 году это уже не гипотеза, а рабочая данность. Задача не в том, чтобы найти «единственно верную» модель, а в том, чтобы выбрать ту, что достаточно честно отражает реальный путь именно ваших клиентов, и регулярно проверять её боевыми тестами, а не верить цифрам в отчёте на слово.
Ещё год назад «AI-агент» звучало как маркетинговая метафора. Сейчас это конкретный продукт: сервисы, которые не просто отвечают на запрос, а несколько раз перепроверяют себя, спорят «сами с собой» или генерируют десяток вариантов и выбирают лучший. Такой подход называется оркестрацией — модель тратит больше вычислений на один и тот же вопрос, чтобы получить более качественный ответ. Логика продавцов подобных инструментов простая: чем больше шагов рассуждения, тем умнее результат, а значит, за него не жалко и заплатить больше.
Именно это распространённое допущение и решила проверить экспериментально группа исследователей из Zuse Institute Berlin, TU Berlin и Weizenbaum Institute — Николас Ляйнс, Нико Пеллерити, Яна Гоннерманн-Мюллер и Себастьян Покутта. В начале августа 2026 года они опубликовали работу «When Does LLM Orchestration Pay Off? A Controlled Evaluation of Accuracy, Cost, and Task Difficulty» — «контролируемое» исследование в том смысле, что авторы намеренно убрали из сравнения все посторонние переменные, которые обычно смазывают такие тесты: разный бюджет на оптимизацию, разные наборы задач для разных методов, разные модели «под капотом». Осталась одна переменная — сама оркестрация — и вопрос, окупает ли она себя.
Что проверяли
Авторы сравнили три популярных метода «оркестрации» языковых моделей — Self-Refine (модель дорабатывает свой же ответ), Best-of-N (генерируется несколько вариантов, выбирается лучший) и Debate (несколько «ролей» модели спорят друг с другом) — против обычного одиночного запроса и запроса с пошаговым рассуждением (chain-of-thought). Тестировали на пяти разных моделях и трёх типах задач: конкурентное программирование, шахматные задачи и математика. Чтобы сравнение было честным, каждый метод оптимизировали с одинаковым бюджетом — иначе можно случайно сравнить «прокачанный» подход с «сырым».
Главный вывод: прирост есть, но он маленький и дорогой
В среднем оркестрация дала прирост точности на 4,5–4,6 процентных пункта по сравнению с обычным запросом. Звучит неплохо — до тех пор, пока не смотришь на цену: multi-step методы потребляли в 2–4 раза больше токенов, то есть в разы больше вычислений и денег на один и тот же ответ.
Чтобы почувствовать масштаб, переведём это в понятные величины. Допустим, обычный запрос к модели для генерации рекламного текста стоит условно 1 рубль в токенах. Оркестрированная версия того же запроса — с самопроверкой или несколькими вариантами на выбор — обойдётся в 2–4 рубля. При объёме в несколько тысяч креативов в месяц разница уходит далеко за пределы «незаметных расходов на AI» и превращается в отдельную строку бюджета, которую надо явно оправдывать приростом в 4–5 процентных пунктов точности — а не подразумеваемым «ну наверняка стало лучше».
Три наблюдения, которые ломают привычную интуицию
Помимо самого факта, что оркестрация не бесплатна, у исследования есть три вывода, которые расходятся с тем, что подсказывает здравый смысл.
- Прирост от оркестрации не растёт вместе со сложностью задачи. Интуиция подсказывает: чем труднее вопрос, тем полезнее «подумать несколько раз» — примерно так и объясняют ценность multi-step подходов их разработчики. Авторы специально проверили эту связь на задачах, размеченных по человеческой оценке сложности, и не нашли, что относительная выгода от оркестрации растёт вместе с трудностью. Иногда сложная задача выигрывает от дополнительных шагов не больше, чем простая.
- Эффективность метода сильно зависит от конкретной модели, а не только от самого метода. Исследователи обнаружили выраженное взаимодействие «метод × модель»: один и тот же Best-of-N может ощутимо поднимать точность на одной модели и почти не давать эффекта на другой. Из этого следует не самый удобный практический вывод — прежде чем внедрять оркестрацию, недостаточно один раз протестировать метод в целом, нужно проверять его именно на той модели, которую вы собираетесь использовать в проде.
- Дороже — не значит стабильно лучше. Разброс результатов между моделями внутри одного и того же метода оркестрации в отдельных случаях оказывался больше, чем разница между самим методом и baseline. То есть выбор модели под капотом иногда важнее, чем то, оркестрируете вы её ответы или нет.
При чём тут маркетинг
Формально исследование — про соревновательное программирование, шахматы и математику. Но вывод куда шире и касается любого маркетолога, который сейчас выбирает AI-инструменты для работы с рекламой. Вот три типичных сценария, где логика исследования применима напрямую.
- Генерация креативов. Сервисы, которые предлагают «AI пишет вариант, сам его критикует и переписывает» — это Self-Refine в чистом виде. Дополнительный проход действительно иногда убирает очевидные огрехи текста, но по данным исследования далеко не всегда оправдывает удвоенную-утроенную стоимость генерации по сравнению с обычным запросом плюс быстрая правка человеком.
- Чат-боты поддержки и обработка обращений. Debate-подход, где несколько «ролей» модели спорят перед финальным ответом, снижает вероятность откровенно неверного ответа, но заметно увеличивает время отклика и стоимость каждого диалога. Для несложных типовых обращений («где мой баланс», «как пополнить счёт») это избыточно; для спорных ситуаций с деньгами клиента — может быть оправдано.
- Автоматическая проверка текстов на соответствие гайдлайнам. Best-of-N, где генерируется несколько вариантов проверки и выбирается наиболее уверенный, полезен там, где цена пропущенной ошибки высока (например, юридические формулировки в рекламе финансовых продуктов), и избыточен для рутинной проверки орфографии.
Как оценить, окупается ли оркестрация именно у вас
Исследование предлагает не просто «доверяй или не доверяй», а конкретный способ проверки, который несложно повторить на своих задачах.
- Шаг 1. Зафиксировать baseline — качество и стоимость обычного одиночного запроса на репрезентативной выборке ваших реальных задач, а не на трёх удачных примерах.
- Шаг 2. Прогнать ту же выборку через оркестрированную версию с той же моделью и посчитать не только итоговое качество, но и фактический расход токенов — большинство API считает его в биллинге напрямую.
- Шаг 3. Посчитать цену одного процентного пункта прироста качества — прирост точности, делённый на разницу в стоимости. Именно это число, а не абсолютный прирост качества, стоит сравнивать между разными инструментами.
- Шаг 4. Повторить тест при смене базовой модели — исследование прямо показывает, что вывод для одной модели не переносится автоматически на другую.
Что с этим делать
- Спрашивать не «сколько шагов», а «что именно эти шаги дают». Дополнительное согласование или самопроверка полезны для задач с высокой ценой ошибки (юридические тексты, финансовые расчёты) и почти бесполезны для рутинной генерации вариантов заголовков.
- Сравнивать прирост качества с ростом стоимости на своих данных, а не на демо вендора. 4–5 п.п. точности за четырёхкратный рост токенов может окупаться в одном сценарии и быть убыточным в другом.
- Не считать сложность задачи автоматическим оправданием для более «тяжёлого» AI-инструмента — исследование показывает, что эта связь далеко не всегда работает.
- Тестировать конкретную пару «инструмент + модель», которую предлагает поставщик решения, а не переносить чужие бенчмарки на свой стек.
Оркестрация — не плохая идея сама по себе, и в части сценариев она действительно окупается. Но относиться к ней стоит как к любому другому платному апгрейду: с калькулятором в руках, а не с верой в то, что «больше AI» автоматически значит «лучше результат».
Август традиционно проседает: часть аудитории в отпуске, часть — «мысленно» ещё не вернулась к работе, бюджеты у многих рекламодателей идут вторым эшелоном после летнего затишья. В сентябре картина резко меняется — и это не только сезонность в духе «дети пошли в школу». Это стык сразу нескольких волн спроса, которые накладываются друг на друга.
Что именно возвращается в сентябре
- Аудитория. Пользователи возвращаются из отпусков и снова начинают активно искать, сравнивать и покупать. Заметнее всего это в категориях с накопленным за лето отложенным спросом: бытовая техника и мебель (обустройство после переезда, покупки к учебному году), образовательные курсы и допобразование (традиционный старт учебного года распространяется и на взрослую аудиторию — курсы, сертификации, изучение языков), а также автомобильная тематика — часть дилеров традиционно запускает осенние акции именно в этот период.
- Деловой цикл. Компании, которые в июле-августе «морозили» решения — не потому что расхотели, а потому что ключевые люди были в отпусках — в сентябре одновременно возобновляют переговоры, тендеры и согласования бюджетов. Для B2B-рекламы это часто даёт более заметный и более резкий скачок обращений, чем для розницы, потому что решения, накопившиеся за два месяца, разблокируются почти одновременно.
- Подготовка к Q4. Ритейл и e-commerce начинают готовиться к пиковому сезону распродаж заранее — тестируют креативы, прогревают аудитории, распределяют бюджеты на предстоящие месяцы. Сентябрь в этом смысле — не сам пик, а разгон перед ним: то, что не протестировано сейчас, придётся дорабатывать уже в разгар ноябрьской конкуренции.
Как спрос меняется внутри самого сентября
Полезно смотреть на месяц не как на единый всплеск, а как на три разные по характеру недели.
- Первая неделя. Аудитория ещё частично «раскачивается» — отпускной режим уходит не мгновенно, активность растёт постепенно. Конкуренция за показы пока умеренная, и это хорошее окно для того, чтобы обновить и протестировать креативы малым бюджетом, пока ставки не разогрелись.
- Вторая-третья недели. Основной пик: деловой цикл разблокировался полностью, аудитория вернулась к привычным паттернам поиска и покупок. Именно здесь обычно наблюдается наиболее заметный рост CPC и CPM — конкуренция за внимание максимальная.
- Последняя неделя. Острота конкуренции немного спадает — рекламодатели, которые уже обновили кампании в начале месяца, выходят на стабильный режим показов. Одновременно стартует подготовка к Q4, поэтому в конце сентября часто выгоднее вкладываться в прогрев аудиторий для будущих распродаж, чем конкурировать за горячий спрос здесь и сейчас.
Что это значит для ставок и конкуренции
Одновременный возврат спроса от разных категорий рекламодателей закономерно повышает конкуренцию за показы. В первые недели сентября это часто ощущается как рост CPC и CPM практически на всех площадках — не потому что что-то сломалось в кампании, а потому что рынок в моменте становится плотнее. Это общерыночная динамика, а не особенность отдельной площадки: примерно то же самое происходит и в поисковой рекламе, и в социальных сетях, и в мессенджерах.
Разумная тактика — не бороться с этим ростом ставками «в лоб», а скорректировать саму стратегию под период высокой конкуренции.
Что стоит сделать в первые недели сентября
- Пересмотреть аудитории, которые «остыли» за лето. Ретаргетинг на пользователей, которые взаимодействовали с брендом весной, часто работает лучше и дешевле, чем холодный охват в разгар сезонного пика спроса — эти пользователи уже знакомы с продуктом, и для их «повторного прогрева» не нужен весь путь воронки заново.
- Обновить креативы до старта основной волны. Реклама, которая простояла без изменений всё лето, теряет эффективность из-за баннерной слепоты — стоит обновить её именно в первую, менее конкурентную неделю сентября, а не ждать, пока ставка за клик уже вырастет.
- Разнести бюджет по волнам, а не тратить его равномерно. Например: часть бюджета — на разогрев и тесты в первую неделю, основной объём — на вторую-третью неделю пикового спроса, и осознанный резерв — на конец месяца, когда конкуренция за внимание немного стабилизируется, а часть бюджета уже можно переключать на прогрев аудиторий под Q4.
- Проверить настройки перед стартом сезона, а не во время него: актуальность УТП, корректность целей и, отдельно, соответствие требованиям к маркировке — в высокий сезон штраф за упущенный токен или неточную отметку обходится особенно дорого, а исправлять его придётся уже на фоне возросшего трафика.
Типичные ошибки этого периода
- Реагировать на рост CPM простым повышением ставок по всем кампаниям сразу, вместо того чтобы в первую очередь выделить и приоритизировать более тёплые, уже знакомые с брендом сегменты аудитории.
- Запускать новые креативы одновременно с пиком конкуренции, а не заранее — в результате тестирование гипотез накладывается на самый дорогой трафик месяца.
- Распылять бюджет по слишком большому числу новых кампаний вместо того, чтобы в первую очередь реактивировать уже отработанные связки на «оттаявшую» аудиторию.
- Откладывать проверку маркировки и другой рутинной комплаенс-гигиены на «после запуска сезона» — именно в этот период объём размещений резко растёт, а вместе с ним и цена одной пропущенной ошибки.
Сентябрьский рост спроса — это не один пик, а наложение нескольких волн: аудитория, деловой цикл и подготовка к Q4 работают параллельно и по-разному проявляются в течение месяца. Кампании, которые готовятся к этому заранее — с обновлёнными креативами, разумным распределением бюджета по неделям и вниманием к «остывшим» аудиториям — проходят этот период куда эффективнее, чем те, что просто увеличивают ставки в моменте.
Wildberries и Ozon — два крупнейших маркетплейса в России, и оба предлагают собственные рекламные инструменты для продвижения карточек товаров. Вопрос «что лучше — WB или Ozon» звучит от продавцов регулярно, особенно от тех, кто только выходит на маркетплейсы и хочет сразу понять, куда вкладывать ограниченный бюджет. Правильный ответ звучит иначе, чем ожидает большинство: смотря какая у вас категория товара, какая задача — вывод новинки или масштабирование уже продающейся карточки — и какой бюджет вы готовы протестировать. Разбираем форматы обеих площадок подробно, без попытки объявить одного победителя на все случаи.
Форматы продвижения на Wildberries
На Wildberries основной инструмент продвижения — реклама в поиске и каталоге, где размер ставки определяет позицию карточки в выдаче по конкретному поисковому запросу. Механика похожа на классический SEM: вы задаёте ключевые слова, по которым хотите показываться, устанавливаете ставку за клик или за позицию, и чем конкурентнее ниша — тем выше стоимость попадания в топ выдачи. Дополнительно доступны баннерные размещения на главной странице и в карточках категорий, которые работают скорее на охват и узнаваемость, чем на прямую конверсию. Для новых продавцов без истории продаж реклама в поиске — практически обязательный инструмент, потому что органическое ранжирование на старте карточки будет крайне низким.
Форматы продвижения на Ozon
Ozon предлагает более широкий набор инструментов, чем Wildberries. Продвижение в поиске работает по схожей логике, но дополнено трафаретами — баннерными форматами, которые показываются прямо в карточках товаров-конкурентов и в категориях, что позволяет «перехватывать» внимание покупателя ещё до принятия решения. Отдельно стоит медийная реклама вне самой площадки — через собственную рекламную сеть Ozon, которая охватывает партнёрские сайты и приложения. Ещё один инструмент — отдельный Performance-кабинет, логика которого гораздо ближе к привычным рекламным системам: там доступна гибкая настройка аудиторий по интересам и поведению, а также ретаргетинг на тех, кто уже смотрел карточку, но не купил.
Чем отличается логика ранжирования карточек
На Wildberries органическое ранжирование сильно зависит от истории продаж и отзывов: чем больше карточка продаёт и чем выше её рейтинг, тем выше она поднимается в выдаче без дополнительных вложений. Рекламная ставка в этой модели скорее ускоряет попадание в топ на старте, но не заменяет саму репутацию карточки — плохо продающийся товар с рекламой не станет продаваться намного лучше. На Ozon алгоритм ранжирования больше учитывает поведенческие сигналы: CTR карточки, среднее время просмотра, добавления в избранное и в корзину. Из-за этого реклама на Ozon быстрее «подсвечивает» карточку алгоритму даже при небольшом количестве продаж.
Стоимость входа и минимальные бюджеты
Порог входа на обеих площадках для тестового бюджета сопоставим и рассчитан на небольшие суммы — можно протестировать канал без крупных вложений. Разница скорее в том, как быстро расходуется бюджет: на Wildberries в высококонкурентных категориях — одежда, косметика — ставки за клик в поиске могут расти заметно быстрее, чем на Ozon, где часть трафика распределяется через менее конкурентные форматы вроде трафаретов. Начинающим продавцам разумно закладывать тестовый бюджет с запасом именно под первую неделю размещения — на этом этапе идёт калибровка ставок и алгоритмов, и расход часто выше, чем в последующие недели.
Когда выбрать WB, когда Ozon
Если ваша категория — одежда, обувь или товары с высокой частотой органического поиска, Wildberries обычно даёт более предсказуемый ROI за счёт зрелой поисковой модели и большого объёма трафика именно в этих категориях. Если вы выводите новый товар без истории продаж или работаете в категории с длинным циклом принятия решения — электроника, товары для дома, техника, — инструменты Ozon с ретаргетингом и медийными форматами часто отрабатывают эффективнее на старте, потому что позволяют «догонять» покупателя, который уже проявил интерес, но не купил сразу.
Как тестировать обе площадки одновременно
Если бюджет позволяет, разумнее не выбирать одну площадку раз и навсегда, а тестировать параллельно с самого начала — характеристики аудитории и алгоритмов ранжирования достаточно разные, чтобы одна и та же карточка показывала разные результаты. Заведите отдельные UTM-метки и раздельную аналитику по каждой площадке, чтобы не смешивать статистику и честно сравнивать ROI. Через 3–4 недели параллельного теста станет понятно, какая площадка лучше отрабатывает конкретно для вашей категории и продукта, и уже тогда можно перераспределять бюджет в пользу более эффективного канала.
Обе площадки стоит тестировать параллельно хотя бы на старте, если бюджет позволяет, — характеристики аудитории и алгоритмов достаточно разные, чтобы одна и та же карточка показывала разные результаты. Универсального победителя тут нет, есть только совпадение вашей категории с сильными сторонами конкретной площадки.
Пиковый сезон распродаж — это не только рост спроса и выручки, но и рост технических рисков: резкие скачки CPM из-за одновременной активности всех рекламодателей рынка, исчерпанные дневные лимиты бюджета, фрод-трафик, который незаметно подъедает бюджет за считаные часы. Большинство проблем в этот период возникают не из-за плохой стратегии или неудачного креатива, а из-за банальных операционных недочётов, которые легко упустить в предпраздничной спешке. Собрали подробный чек-лист того, что стоит проверить заранее по срокам — за месяц, за две недели, за неделю и непосредственно в день старта, — чтобы не тушить пожар в разгар распродажи.
За месяц до старта: полный аудит кабинетов
Проверьте лимиты дневного и общего бюджета во всех рекламных кабинетах, которые планируете использовать в сезон, — в пиковый период дефолтные лимиты, настроенные под обычный трафик, часто оказываются заметно занижены и автоматически останавливают показ кампании в самый неподходящий момент. Убедитесь, что все платёжные методы актуальны, а на счетах достаточно средств с запасом, чтобы кампании не остановились посреди самого горячего дня распродажи из-за банальной нехватки баланса. Проверьте доступы всех членов команды к нужным кабинетам заранее — вам точно не нужен инцидент с потерянным паролем или заблокированным доступом именно в тот момент, когда требуется срочно скорректировать ставки.
За месяц до старта: план по креативам
Составьте календарь смены креативов на весь период распродажи заранее, а не в последний момент. Аудитория, которая видит один и тот же баннер несколько дней подряд в высококонкурентный период, быстро выгорает, и CTR падает даже при сохранении спроса на сам товар. Подготовьте минимум два-три варианта основного креатива и отдельно версии под конкретные этапы распродажи: анонс, старт, последний день, — это работает заметно лучше, чем один универсальный баннер на всё время акции.
За две недели: лимиты и бюджетные буферы
Заложите буфер в 15–20% сверх планового бюджета на случай роста CPM в самые пиковые дни — конкуренция за аукцион в дни массовых распродаж растёт одновременно у всех участников рынка, и стоимость показа может ощутимо вырасти именно тогда, когда трафик особенно ценен. Подготовьте резервные креативы на случай, если основные исчерпают эффективность за первые дни распродажи, — обновлённый визуал зачастую восстанавливает CTR быстрее и надёжнее, чем попытки исправить ситуацию исключительно корректировкой ставок.
За неделю: антифрод и технические проверки
Проверьте настройки антифрод-фильтров во всех источниках трафика заранее — в пиковые периоды закономерно растёт и активность ботов, которые целенаправленно охотятся именно за акционными предложениями и промокодами. Обязательно протестируйте посадочные страницы под нагрузкой: сайт, который стабильно работает при обычном ежедневном трафике, далеко не всегда выдерживает резкий всплеск посещаемости в день старта распродажи. Убедитесь, что аналитика и UTM-метки настроены и протестированы заранее — восстановить корректные данные по трафику постфактум, когда акция уже прошла, невозможно физически.
В день старта: ручной контроль первых часов
Держите ключевые кампании под ручным контролем как минимум первые несколько часов после старта распродажи — автоматические стратегии оптимизации ставок иногда не успевают адаптироваться к резкому скачку конкуренции в аукционе и могут какое-то время работать неэффективно, пока алгоритм не соберёт достаточно новых данных. Следите за реальным CPL или CPA буквально в реальном времени, а не только по итогам дня: если метрика резко ушла в минус в первые часы, разумнее временно приостановить конкретную кампанию и разобраться в причине, чем продолжать сливать бюджет ещё несколько часов.
После пикового дня: что зафиксировать для следующего раза
Сразу после завершения самого горячего дня распродажи зафиксируйте ключевые метрики и наблюдения, пока детали ещё свежи в памяти: какие креативы отработали лучше всего, в какие часы был максимальный расход бюджета, какие технические проблемы возникли и как их решили. Такой пост-мортем занимает буквально полчаса, но экономит гораздо больше времени при подготовке к следующему сезону распродаж — вы будете точно знать, какие пункты чек-листа сработали, а что стоит доработать в следующий раз.
Большая часть проблем в пиковый сезон распродаж — это не про креатив или стратегию таргетинга, а про операционные детали, которые легко упустить в предпраздничной спешке. Подробный чек-лист, пройденный за месяц до старта, экономит гораздо больше нервов и бюджета, чем кажется на первый взгляд.
Всё больше пользователей соцсетей открыто жалуются на то, что алгоритмическая лента решает за них, что смотреть и в каком порядке, — а регуляторы в разных странах всё активнее обсуждают право пользователя на «алгоритм-опт-аут», то есть возможность отключить алгоритмическую сортировку и вернуться к простой хронологической ленте. Для таргетолога это не абстрактная тема из области футурологии, а вопрос, который может напрямую повлиять на охваты и стоимость показов уже в ближайшие пару лет. Разбираем, откуда взялся этот запрос, что уже тестируют платформы и как заранее подготовить рекламную стратегию к возможным изменениям.
Почему пользователи и регуляторы требуют контроль над лентой
Алгоритмическое ранжирование ленты по своей природе устроено так, чтобы максимально удерживать внимание пользователя внутри приложения, — а самый надёжный и проверенный способ удержать внимание нередко оказывается показ спорного, эмоционально заряженного или откровенно провокационного контента, который вызывает сильную реакцию. Именно этот механизм подпитывает и растущую усталость обычных пользователей от бесконечной ленты, и всё более серьёзную озабоченность регуляторов, которые всё чаще напрямую связывают алгоритмическое ранжирование с ростом общественной поляризации и манипулятивным воздействием на аудиторию, особенно на уязвимые группы вроде подростков и молодой аудитории.
Что уже тестируют крупные платформы
Некоторые крупные платформы уже добавили в настройки опции ограничения AI-генерированного и алгоритмически подобранного контента в ленте — пока в довольно мягкой форме, в виде переключателей «показывать меньше» определённых типов материалов, а не полного отключения ранжирования как такового. Регуляторы в ряде юрисдикций тем временем подталкивают платформы к более радикальному шагу — законодательно закреплённой возможности переключиться на полностью хронологическую ленту без какой-либо алгоритмической сортировки вообще, по крайней мере в качестве доступной пользователю опции, а не единственного режима работы приложения.
Почему полное отключение алгоритмов маловероятно в ближайший год
Стоит сразу отметить: массовый и обязательный переход на хронологические ленты в ближайшей перспективе выглядит маловероятным сценарием. Алгоритмическое ранжирование — коммерческая основа бизнес-модели большинства крупных социальных платформ: именно оно обеспечивает время, проведённое в приложении, а значит, и рекламные доходы. Даже под давлением регуляторов платформы, скорее всего, будут двигаться в сторону опциональных настроек и большей прозрачности алгоритма, а не полного отказа от персонализации ленты, которая объективно повышает вовлечённость для значительной части аудитории.
Как это может сказаться на охватах и цене показов
Если доля пользователей с отключённым или заметно ослабленным алгоритмом всё же вырастет, органический охват контента, который раньше выигрывал в первую очередь за счёт алгоритмических сигналов вовлечённости — лайков, комментариев, времени просмотра, — станет менее предсказуемым: часть аудитории будет видеть ленту в простом хронологическом порядке, а не по релевантности. Для платной рекламы это потенциально может означать рост конкуренции за оставшийся «алгоритмический» инвентарь среди пользователей с активной персонализацией и постепенный сдвиг ценности в сторону форматов, которые в принципе работают независимо от алгоритмической сортировки, — email-рассылок, подписных каналов, прямых интеграций.
Какие форматы устойчивы к возможным изменениям алгоритмов
Форматы, которые опираются на прямую подписку пользователя, а не на алгоритмический подбор контента, по определению устойчивее к любым изменениям в логике ранжирования лент — если человек подписан на канал или рассылку напрямую, ему не нужно, чтобы алгоритм угадал его интерес. Это касается email, Telegram-каналов, push-уведомлений с явного согласия пользователя. Стоит также обратить внимание на форматы, которые платформы традиционно продвигают вне зависимости от алгоритмических экспериментов, — закреплённые посты в профиле, разделы «сохранённое», прямые ссылки в описании профиля: эти точки касания менее зависимы от колебаний алгоритмической логики.
Что делать таргетологу уже сейчас
Не стоит паниковать раньше времени — массового и обязательного перехода на ручные ленты в обозримом будущем не предвидится ни на одной крупной платформе, и резко менять всю рекламную стратегию под гипотетический сценарий преждевременно. Но стоит начать диверсифицировать каналы уже сейчас, не полагаясь исключительно на алгоритмический охват как единственный источник трафика: развивать собственную базу подписчиков, тестировать форматы, которые работают вне ленты рекомендаций, — сторис, закреплённые посты, коммьюнити-чаты и группы, — и держать руку на пульсе регуляторных новостей в тех регионах, где присутствует ваша аудитория.
Полное отключение алгоритмов маловероятно в ближайший год, но сам тренд на растущий пользовательский запрос к контролю над лентой уже задаёт направление развития платформ на годы вперёд — и разумнее подготовить рекламную стратегию заранее, чем реагировать по факту, когда охваты уже начнут падать.
Провалы больших брендов с AI-рекламой — не повод позлорадствовать над чужими ошибками, а по сути бесплатный курс по управлению репутационными рисками для тех, у кого бюджет и медийный вес в сто раз меньше. Когда Coca-Cola или Levi’s ошибаются с AI-креативом, это становится заметным медийным событием именно из-за масштаба бренда — но сама логика ошибки универсальна и легко повторяется в кампаниях гораздо меньшего масштаба. Разбираем два громких кейса подробно и то, что каждый из них изменил в практике использования AI крупными брендами.
Coca-Cola: два года подряд одна и та же ошибка
В 2024 году Coca-Cola выпустила полностью сгенерированный нейросетью праздничный ролик — переосмысление классической рождественской рекламы 1995 года с грузовиками и огнями. Аудитория раскритиковала визуал за «неживых», неестественно двигающихся людей и ощущение подменённой, искусственной ностальгии, а часть креативного сообщества расценила выход ролика как демонстративное вытеснение живых актёров и аниматоров технологией именно в тот момент, когда индустрия особенно остро обсуждала угрозу для творческих профессий. В 2025 году бренд повторил попытку с новым роликом — на этот раз со сцены с грузовиками убрали людей вовсе, заменив их анимированными животными, — и снова получил заметную волну негатива в соцсетях, хотя технически новый ролик выглядел заметно более отполированным, чем версия годом ранее. Руководство компании публично защищало решение продолжать эксперименты с генеративными технологиями, называя происходящее необратимым технологическим сдвигом, но так и не раскрыло публично реальную стоимость производства кампании — что только подогрело подозрения комментаторов, что заявленная экономия на AI-производстве оказалась не такой значительной, как декларировалось изначально.
Levi’s и H&M: AI-модели вместо живого кастинга
Levi’s ещё несколько лет назад анонсировала пилотный проект по использованию AI-сгенерированных моделей на фотографиях товаров, заявив, что цель эксперимента — «увеличить разнообразие» представленных на фото типажей без необходимости организовывать более масштабные и дорогие живые съёмки. Реакция аудитории оказалась прямо противоположной ожидаемой: пользователи и часть индустрии моды восприняли инициативу как попытку сэкономить именно на найме реальных моделей разных типажей, по сути подменив настоящее разнообразие искусственно сгенерированной имитацией. Компании пришлось публично уточнить формулировку: технология не заменит живые фотосъёмки полностью и не является частью официальной политики по разнообразию, — по сути, мягко откатить первоначальное заявление без прямого извинения перед аудиторией. Позже с похожей волной критики столкнулась и H&M, которая начала использовать AI-двойников реальных моделей для части рекламных материалов, — пользователи назвали это обезличенным клонированием, лишающим смысла саму идею живой фотосъёмки.
Что объединяет оба кейса
В обоих случаях камнем преткновения стала не сама технология как таковая, а тема, на которой бренды решили её применить: человеческий труд и репрезентация. Праздничная реклама Coca-Cola исторически строилась на ощущении тепла и человечности — именно поэтому подмена живых актёров и аниматоров технологией воспринималась особенно болезненно. У Levi’s и H&M ситуация схожая: тема разнообразия и инклюзивности изначально подразумевает реальных людей разных типажей, а не сгенерированную имитацию разнообразия, — поэтому использование AI именно в этом контексте прочитывалось аудиторией как цинизм, а не как невинная технологическая инновация.
Что бренды поменяли по итогам
В обоих случаях компании не отказались от использования AI полностью, но заметно скорректировали публичную коммуникацию: перестали подавать AI-контент как полноценную замену живым людям и стали явнее объяснять аудитории, зачем вообще используют технологию — обычно это экономия времени и производственных издержек, а не заявленное улучшение качества или результата кампании. Coca-Cola продолжила эксперименты с генеративными технологиями в следующих кампаниях, но фактически признала на уровне публичных комментариев руководства, что технология пока не решает проблему «зловещей долины» при анимации реалистичных человеческих фигур и, судя по всему, не планирует полностью отказываться от живых съёмок там, где нужна настоящая эмоциональная достоверность.
Уроки для рекламодателя с бюджетом поменьше
Главный урок из обоих кейсов — не в том, что AI-креатив в принципе работает или не работает, а в том, что аудитория особенно чувствительна к темам, где на кону стоит человеческий труд, идентичность или репрезентация. Если тема вашей кампании завязана на ностальгию, эмоциональную близость, идентичность аудитории или разнообразие — то есть на сферы, где люди по умолчанию ожидают живого человеческого касания, — экономия на AI-производстве обходится дороже репутационно, чем прямые денежные затраты на живую съёмку или кастинг. Для нейтральных, технических или чисто продуктовых тем риск использования AI-креатива заметно ниже.
Как проверить риск заранее, до запуска кампании
Перед тем как утверждать AI-креатив для публикации, стоит задать себе простой вопрос: если бы аудитория узнала, что перед ней AI-генерация, восприняли бы они это как невинную технологическую деталь или как циничную экономию на теме, которая для них эмоционально значима? Если тема кампании связана с людьми, семьёй, праздниками, идентичностью или инклюзивностью — стоит либо явно промаркировать AI-элементы, либо вообще избежать генерации в этой части креатива. Небольшой предварительный опрос фокус-группы из нескольких лояльных клиентов часто позволяет заметить потенциальную проблему до запуска, а не после волны негативных комментариев.
AI-инструменты объективно снижают производственные затраты, но не снимают с бренда ответственности за то, какое сообщение в итоге получает аудитория, — и этот баланс стоит просчитывать до запуска кампании, а не разбираться с последствиями постфактум, когда репутационный ущерб уже нанесён.